Farsi trovare da ChatGPT e dalle AI Overview: cosa dipende davvero dal sito
Chi riceve una proposta di «SEO per AI» vuole sapere che cosa fare al sito per comparire nelle risposte di ChatGPT e nelle AI Overview. La risposta onesta: in larga parte è SEO fatta bene. Google mostra come fonti solo pagine già indicizzate, mentre OpenAI, Anthropic e Perplexity documentano un proprio crawler di ricerca e la lettura della pagina su richiesta. Qui distinguiamo, fonte per fonte, ciò che è documentato da ciò che è folclore, e indichiamo le verifiche che dipendono dal sito.
In questo articolo
Che cosa si intende per SEO per AI e quanto assomiglia alla SEO di sempre
Il nome cambia con chi lo propone: «SEO per AI», GEO, AEO. GEO sta per generative engine optimization, AEO per answer engine optimization. Indicano tutti lo stesso lavoro: far comparire un sito fra le fonti che un motore o un assistente cita quando compone una risposta.
Per Google questo lavoro è ancora SEO, e lo scrive nella sua guida all’ottimizzazione per le funzionalità di AI generativa nella Ricerca (si apre in una nuova scheda). Il motivo è tecnico: AI Overview e AI Mode, le funzioni generative della Ricerca, poggiano sui suoi sistemi di ranking e recuperano le pagine dal suo indice. Una pagina fuori dall’indice resta fuori anche da quelle risposte.
Dal sito dipende che i crawler, cioè i programmi che scaricano le pagine per un motore o un assistente, possano entrare. Dipende anche che cosa trovano: contenuto in forma leggibile e pagine che dicono di che cosa parlano. La scelta delle fonti resta al motore o all’assistente. Chi compra un servizio con questo nome compra, nella parte che funziona, SEO tecnica e buoni contenuti: conviene saperlo prima di confrontare le offerte.
Come un assistente arriva alle fonti: indice, crawler e pagine lette al momento
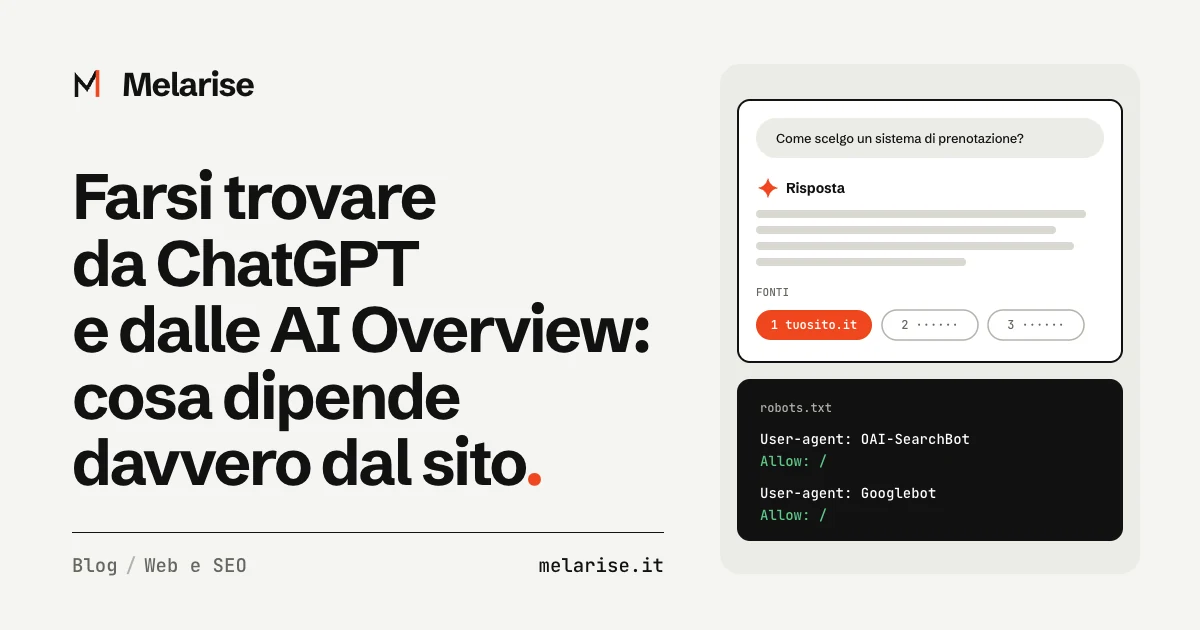
Le strade documentate sono tre. Il file robots.txt, con cui un sito dice ai crawler dove possono entrare, non pesa su tutte allo stesso modo. La prima è un indice di ricerca. Per Google è quello della Ricerca, costruito da Googlebot. Gli altri operatori documentano un crawler dedicato: OAI-SearchBot nella panoramica dei crawler di OpenAI (si apre in una nuova scheda), Claude-SearchBot nella pagina di assistenza di Anthropic sui crawler (si apre in una nuova scheda), PerplexityBot nella documentazione dei crawler di Perplexity (si apre in una nuova scheda).
OpenAI aggiunge, nel suo centro assistenza, che la ricerca di ChatGPT a volte si appoggia ad altri fornitori di ricerca, senza dire in quale misura. Chi indica con certezza un solo motore su cui posizionarsi per comparire in ChatGPT afferma più di quanto OpenAI dichiari.
La seconda strada è la raccolta per l’addestramento dei modelli: GPTBot per OpenAI, ClaudeBot per Anthropic. Google usa il token Google-Extended, cioè una voce di robots.txt senza un crawler proprio, che copre anche l’uso dei contenuti come fonte delle risposte nelle app Gemini. L’addestramento riguarda i modelli futuri ed è separato dalla ricerca: OpenAI dichiara le due impostazioni indipendenti, quindi un sito può consentire OAI-SearchBot e negare GPTBot.
La terza è la lettura su richiesta. Quando una persona fa una domanda, l’assistente può aprire una pagina in quel momento con un agente dedicato: ChatGPT-User, Claude-User, Perplexity-User. Qui robots.txt conta meno. OpenAI scrive che le regole potrebbero non applicarsi, Perplexity che in genere vengono ignorate, mentre Anthropic presenta Claude-User come controllabile dal sito.
I crawler degli assistenti e come si controllano dal file robots.txt
I nomi sono quelli delle pagine ufficiali al momento in cui scriviamo (ottobre 2026). Per Google-Extended la fonte è l'elenco dei crawler di Google (si apre in una nuova scheda). Resta fuori OAI-AdsBot di OpenAI, che riguarda solo chi fa pubblicità su ChatGPT.
| Operatore e crawler | A che cosa serve secondo la documentazione | Come si controlla |
|---|---|---|
| OpenAI, OAI-SearchBot | Far comparire i siti nella ricerca di ChatGPT. | robots.txt. Chi lo esclude esce dalle risposte di ricerca, ma può restare come link di navigazione. Una modifica può richiedere circa 24 ore. |
| OpenAI, GPTBot | Raccogliere contenuti che possono servire ad addestrare i modelli. | robots.txt. Un Disallow segnala di non usarli per l’addestramento. |
| OpenAI, ChatGPT-User | Aprire una pagina su richiesta dell’utente. | Le regole di robots.txt potrebbero non applicarsi. Non decide la presenza nella ricerca. |
| Anthropic, ClaudeBot | Raccogliere contenuti che possono contribuire all’addestramento. | robots.txt, da ripetere per ogni sottodominio. |
| Anthropic, Claude-SearchBot | Migliorare la qualità dei risultati di ricerca. | robots.txt. Disabilitarlo può ridurre la visibilità nei risultati. |
| Anthropic, Claude-User | Leggere una pagina su richiesta dell’utente. | robots.txt, secondo Anthropic. |
| Perplexity, PerplexityBot | Far comparire e collegare i siti nei risultati di Perplexity. | robots.txt, più gli indirizzi IP pubblicati da lasciar passare. |
| Perplexity, Perplexity-User | Visitare una pagina su richiesta dell’utente. | In genere ignora robots.txt, perché la richiesta parte dall’utente. |
| Google, Google-Extended | Dire se i contenuti possono addestrare i modelli Gemini e alimentarne le risposte. | Token di robots.txt. Non incide sull’inclusione né sul ranking nella Ricerca, di cui AI Overview e AI Mode sono funzioni. |
Quello che Google documenta su AI Overview e AI Mode
Secondo gli annunci di Google, in Italia AI Overview c’è da marzo 2025 e AI Mode da ottobre 2025. Il resto viene dalla documentazione di Search Central e dalla guida di Search Console.
Il requisito: pagina indicizzata e mostrabile con uno snippet
Per comparire come link in una risposta generata la pagina deve essere nell’indice e mostrabile con uno snippet, cioè un’anteprima di testo. Non servono file o marcature speciali. Google precisa che indicizzazione e pubblicazione non sono garantite e che le AI Overview spesso non si attivano.
Il controllo in Search Console, per tutti dal 31 agosto 2026
Nelle impostazioni di Search Console c’è il «Controllo dell’AI generativa nella Ricerca», con tre scelte: includere il sito, escluderlo, ereditare dalla proprietà principale. L’inclusione è predefinita: basta verificare che nessuno l’abbia cambiata. Il controllo non riguarda l’addestramento dei modelli e, secondo la guida, escludersi non pesa sul ranking nel resto della Ricerca.
Le leve per mostrare meno: nosnippet, max-snippet, noindex
La regola nosnippet impedisce che il contenuto sia usato come input diretto per AI Overview e AI Mode, max-snippet ne limita la quantità, data-nosnippet tiene fuori dallo snippet una porzione di pagina. Tutte e tre agiscono anche sull’anteprima nei risultati classici. Per uscire del tutto dalla Ricerca c’è noindex.
I dati: impressioni sì, clic e query no
Dalla fine di agosto 2026 Search Console offre a tutti i siti il «Report sul rendimento dell’AI generativa». Mostra le impressioni, cioè quante volte un link al sito è comparso in quelle risposte, per pagina, paese, data e dispositivo. La guida non elenca clic né query, e il report può mancare se le impressioni sono poche.
Cosa controllare sul sito: le verifiche che dipendono da te
Chi chiede come fare SEO per AI trova qui, in buona parte, ciò che Google indica come ancora valido. Aggiungiamo due trappole tecniche poco note, nel file robots.txt e nei firewall, e criteri nostri su titoli, autore e data.
Il contenuto principale è nell’HTML servito
Basta aprire una pagina, scegliere «Visualizza sorgente pagina» e cercare una frase del testo. Se manca, il contenuto nasce solo dopo l’esecuzione del JavaScript. Googlebot lo esegue, in una fase successiva. Le pagine ufficiali sui crawler degli assistenti non dicono se lo fanno, e Google ricorda che non tutti i bot ne sono capaci. Servire il testo già nell’HTML toglie il dubbio.
Il file robots.txt non blocca per errore
Il file si legge dal browser, aggiungendo /robots.txt al dominio. La trappola sta nei gruppi dedicati. Per la RFC 9309, che definisce il protocollo, un crawler che trova un gruppo con il proprio nome segue quello e ignora il gruppo generale. Le regole scritte per GPTBot sostituiscono per GPTBot quelle generali, senza sommarsi: i divieti che valevano per tutti vanno ripetuti anche lì.
CDN, firewall e hosting lasciano passare i crawler
Un blocco può nascere fuori da robots.txt: nel firewall o nella CDN, la rete che distribuisce i file del sito. OpenAI scrive che queste protezioni possono fermare i suoi crawler, spesso con un errore 403. Cloudflare documenta impostazioni che bloccano i bot IA per categoria: ricerca, agenti, addestramento. Chi usa un servizio simile deve sapere che cosa blocca e chi lo ha deciso.
Pagine indicizzabili e indirizzo canonico corretto
I requisiti minimi della Ricerca sono tre: Googlebot non bloccato, pagina che risponde con stato 200, contenuto indicizzabile. Si controlla che non sia rimasto un noindex dalla fase di sviluppo e che ogni pagina dichiari l’indirizzo canonico giusto.
Titoli che dicono l’argomento, risposta nelle prime righe
Un titolo come «Servizi» non dice nulla né a chi legge né a chi indicizza. Nel titolo va scritto di che cosa parla la pagina, nelle prime righe la risposta alla domanda per cui esiste.
Dati strutturati coerenti con ciò che si vede
Per le risposte generate Google non li richiede. Restano utili per i risultati avanzati, se descrivono ciò che il lettore vede: le linee guida di Google vietano di marcare contenuti fuorvianti, come le recensioni false. Su Beachfy, la piattaforma per stabilimenti balneari che sviluppiamo, abbiamo rimosso un blocco di valutazioni perché il prodotto è in pre-lancio e recensioni non ne ha.
Autore, data, link interni e sitemap
Autore e data di aggiornamento devono leggersi nel testo, e le pagine importanti vanno raggiunte da link interni. La sitemap aiuta la scoperta senza essere un requisito: Google scrive che un sito piccolo e ben collegato potrebbe farne a meno.
Il caso di questo sito: HTML completo, dati strutturati e robots.txt aperto
L’esempio che chiunque può verificare è il sito che stai leggendo. Ogni pagina di melarise.it viene prodotta in fase di build come file HTML completo di testo, metadati e dati strutturati, e il JavaScript arriva dopo. Nel sorgente di questa pagina si trovano questa frase, l’indirizzo canonico e i dati strutturati dell’articolo. Il perché sta nell'articolo sui Core Web Vitals, alla parte su prerendering e generazione statica.
Il file robots.txt è corto: un solo gruppo «User-agent: *» con «Allow: /» e la riga che dichiara la sitemap. Non nomina alcun crawler, quindi per tutti quelli della tabella vale la regola generale, cioè tutto consentito, raccolta per l’addestramento compresa. Un commento nel file ne dà il motivo: le pagine sono HTML statico, senza aree riservate da escludere.
Lo stesso criterio vale per il sito di DietApp, la nostra app Android per i piani alimentari, su Google Play dal 26 settembre 2025: le pagine pubbliche di diet-app.it sono prerenderizzate. Non vale per tutto ciò che abbiamo online, e lo dichiariamo: la pagina di attesa di Beachfy è resa lato client, e nel sorgente ha titolo, metadati e dati strutturati ma non il testo.
Quello che non possiamo mostrare sono i risultati. Questo sito non usa cookie né strumenti di analisi, quindi non abbiamo misure delle visite arrivate dagli assistenti e non ne inventiamo. Possiamo dire che cosa proponiamo a chi ci chiede un sito web o una piattaforma: HTML già pronto per le pagine pubbliche e dati strutturati che corrispondono al contenuto.
Il file llms.txt e le altre promesse: che cosa è documentato e che cosa no
Il file llms.txt è una proposta aperta ai contributi, e così la presenta il suo stesso sito. L’ha pubblicata un singolo autore, Jeremy Howard, nel settembre 2024, e nell’agosto 2026 è arrivata alla seconda versione. Consiste in un file di testo in formato Markdown, alla radice del sito o di una sua sezione, con una sintesi e i link a versioni in Markdown delle pagine. Dovrebbe leggerlo un assistente mentre compone la risposta.
Fra i quattro operatori la sola posizione netta che abbiamo letto è di Google: la Ricerca ignora questi file, quindi crearli non aiuta né danneggia la visibilità. OpenAI, Anthropic e Perplexity ne pubblicano uno per la documentazione rivolta agli sviluppatori. Nelle loro pagine sui crawler, però, non c’è scritto che gli assistenti lo leggano per scegliere le fonti, e dichiarazioni ufficiali in questo senso non ci risultano.
Il criterio pratico: per la Ricerca Google pubblicarlo non fa danni, quindi può stare fra le voci minori del preventivo di un sito web. Diventa un segnale di allarme quando è la voce principale di un’offerta, o la chiave promessa per farsi citare. Su questo sito non lo pubblichiamo.
Lo stesso trattamento meritano le altre promesse ricorrenti nelle offerte di ottimizzazione SEO per AI. La guida di Google elenca ciò che per la Ricerca si può ignorare: spezzare i testi in blocchi, riscriverli in uno stile apposito per l’IA, inseguire menzioni non autentiche, caricare le pagine di marcature speciali. Per gli altri assistenti non abbiamo trovato indicazioni ufficiali equivalenti. Chi propone regole certe le ricava da prove proprie: conviene chiedere di vederle.
Come verificare se gli assistenti leggono e citano il tuo sito
Quattro controlli alla portata di chiunque. Vanno ripetuti nel tempo, come le altre voci ricorrenti della manutenzione di un sito.
Passo 1: Fare agli assistenti le domande dei clienti
Si scrivono a ChatGPT, a Claude, a Perplexity e in AI Mode le domande che un cliente farebbe prima di scegliere un fornitore, poi il nome dell’attività. Conviene annotare le fonti citate e ripetere dopo qualche settimana. OpenAI avverte che risultati e citazioni possono essere incompleti, non aggiornati o errati.
Passo 2: Aprire i report di Search Console e di Bing
In Search Console c’è il report sulle impressioni in AI Overview e AI Mode. In Bing Webmaster Tools la sezione «AI Performance» conta le citazioni in Copilot e nei riepiloghi di Bing, senza dire in che posizione. Entrambi chiedono un account, che conviene sia tuo, come il dominio e gli altri account del sito.
Passo 3: Cercare i crawler nei log del server
Se l’hosting dà accesso ai log, il registro delle richieste ricevute dal server, si cercano i nomi della tabella: dicono quali crawler passano, su quali pagine e con quale esito. Un errore 403 ripetuto fa pensare a un blocco di firewall o CDN. Su un hosting gestito i log possono mancare.
Passo 4: Guardare da dove arrivano le visite
Se il sito ha uno strumento di analisi, fra le sorgenti di traffico si cercano i domini degli assistenti, a partire da chatgpt.com.
Domande frequenti sulla SEO per AI
Come farsi trovare da ChatGPT?
Consentendo la scansione al crawler OAI-SearchBot e verificando che hosting o CDN lascino passare i suoi indirizzi IP pubblicati. Sono le due condizioni che OpenAI indica perché un sito sia idoneo ai risultati di ricerca di ChatGPT, dove la posizione non è garantita. Il resto è lavoro sulle pagine: risposte a domande precise, con il testo già nell’HTML.
Serve il file llms.txt?
Per Google no: la documentazione dice che la Ricerca, funzioni generative comprese, non usa questi file. Per ChatGPT, Claude e Perplexity non abbiamo trovato una dichiarazione ufficiale che lo indichi come segnale per scegliere le fonti. Pubblicarlo non danneggia la visibilità su Google, ma viene dopo pagine indicizzabili, testo nell’HTML e robots.txt corretto.
Conviene bloccare i crawler delle AI?
Dipende da quali. Nelle pagine ufficiali i crawler di addestramento, come GPTBot e ClaudeBot, hanno regole separate da quelli di ricerca: negarli riguarda l’uso dei contenuti per addestrare i modelli. Negare i crawler di ricerca, come OAI-SearchBot, Claude-SearchBot e PerplexityBot, tocca invece la presenza nelle risposte: chi vuole essere citato li lascia passare. Il token Google-Extended copre anche l’uso come fonte nelle app Gemini e non incide sulla Ricerca Google.
La SEO per AI sostituisce la SEO tradizionale?
No. Per Google ottimizzare per la ricerca con IA generativa resta SEO: AI Overview e AI Mode si reggono sui sistemi di ranking e sull’indice della Ricerca. Per gli altri assistenti dal sito dipendono le stesse cose: pagine raggiungibili, testo leggibile e contenuti che rispondono alla domanda.
Quanto costa una consulenza SEO per AI?
Dipende da quante pagine vanno riviste, dal fatto che il sito serva già il testo nell’HTML e dal perimetro: sole verifiche tecniche oppure anche i contenuti. Controllare robots.txt, indicizzazione e dati strutturati è un lavoro breve, cambiare il modo in cui il sito produce le pagine è un progetto. Conviene chiedere un preventivo a voci e diffidare dei prezzi legati a una promessa di citazione.